从 RoPE 到 NoPE:长上下文中的位置建模正在重新分工
TL;DR
一句话:RoPE 把位置先验直接写进架构;NoPE 把位置交给模型隐式学习。所以有一个趋势是把两者结合分工。
- RoPE 好在哪:用绝对位置的旋转,得到只依赖相对距离的内积(”绝对进、相对出”)。
- RoPE 坏在哪:注意力分数本质是一堆不同频率余弦波的叠加。上下文变长时,稳定的低频项越来越少、振荡的高频项越来越多。
- NoPE 凭什么可行:decoder-only 的 causal mask 已经打破了置换对称性。构造性证明给出一个 head 就能数出绝对位置,后续层还能凑出加性的相对位置项。实测它的注意力模式最像 T5 relative bias。
- 怎么混合:p-RoPE 在一个 head 内留出一部分不旋转的语义通道(Gemma 4, $p=0.25$ );iRoPE 在层间让局部 RoPE 与全局 NoPE 交错(Llama 4)。iRoPE 要生效还得”给全局层留活干”:缩小局部窗口、NoPE 层去掉 QK-Norm、改用 LSSS 排列。
目录
- 1. RoPE:用绝对形式表达相对位置的优雅设计
- 2. 重新审视 RoPE:怎么失灵了
- 3. NoPE:不显式注入位置信息,模型可以隐式地学习到位置吗
- 4. p-RoPE:只旋转部分通道
- 5. iRoPE:让局部位置和全局检索分层协作
- 6. 通用能力与训练效率的初步实验
- 7. 总结:让位置建模各司其职
- 参考文献
当上下文长度从几千个 token 扩展到几十万,甚至更长时,语言模型遇到的瓶颈不只是显存和计算量,还有一个更基础的问题:模型究竟应该如何理解“位置”?
在 Transformer 中,注意力机制本身并不知道两个 token 的先后顺序。为了让模型区分“我爱你”和“你爱我”,研究者引入了各种位置编码,RoPE 出现之前主要的研究可以大致区分成两类:绝对位置编码和相对位置编码。而 RoPE 凭借简洁、有效以及能融合相对位置编码和绝对位置编码的自然建模,成为大语言模型中的主流方案。
RoPE 的做法很优雅:根据 token 所处的位置,对 query 和 key 进行不同角度的旋转。这样一来,两个 token 的注意力分数就会显式依赖它们之间的相对距离。在训练长度以内,这种位置先验通常表现得非常好。
问题出现在更长的上下文中。
当模型被要求处理远超训练窗口的文本时,它面对的是训练阶段没有见过的旋转角度、频率组合和注意力模式。为了延长上下文,研究者不得不引入位置插值、频率缩放、YaRN 或其他复杂的外推方法。即使上下文窗口在形式上被扩展,模型对远距离信息的检索能力仍然可能下降。
这时,一个看似激进的想法重新进入了研究视野:
如果直接不显式注入位置编码,会发生什么?
这就是 NoPE 的出发点。NoPE 不再直接向注意力分数中加入旋转位置编码,而是让模型通过 causal mask 和注意力长短窗口,自己学习隐式的位置关系。令人意外的是,在一些长度泛化任务中,没有显式位置编码的模型反而能够处理更长的序列。
但 NoPE 也不是一个简单的替代方案,模型可能难以学到稳定的位置建模。RoPE 和 NoPE 似乎分别擅长不同的事情:RoPE 提供稳定的短距离位置信息,而 NoPE 更有利于长距离位置理解。
于是,研究问题开始发生变化,进一步追问:不同层、不同维度和不同注意力范围,是否应该使用不同的位置编码机制?
这也引出了近年来逐渐出现的混合方案:让部分层继续使用 RoPE,部分层采用 NoPE;让 RoPE 层负责局部和近期信息,让 NoPE 层负责全局检索;甚至只在部分 attention head 或部分维度中保留旋转位置编码。
本文将从 RoPE 的工作原理和长上下文局限出发,介绍 NoPE 如何学习隐式位置关系,并进一步讨论 RoPE 与 NoPE 的混合设计,尝试回答一个更根本的问题:
长上下文模型需要的,究竟是一套统一的位置编码,还是一种分层的位置分工?
1. RoPE:用绝对形式表达相对位置的优雅设计
非常推荐阅读苏剑林苏神的博客:
- 让研究人员绞尽脑汁的Transformer位置编码 这篇介绍了早期的绝对和相对位置编码,以及早期关于 RoPE 想法的出现,读完之后真的会由衷赞叹苏神的想法,简直是太美妙了。
- Transformer升级之路:2、博采众长的旋转式位置编码 这篇比较详细介绍了 RoPE 的原理。
- 以及 RoPE 的论文: RoFormer: Enhanced Transformer with Rotary Position Embedding
简单说,RoPE 的核心思想是:让 query 和 key 在旋转角度上不同,从而让注意力分数显式依赖相对位置。
1.1 从二维旋转开始
先把 query 或 key 的两个相邻维度看成一个二维向量。对于位置 $m$ ,RoPE 用旋转矩阵将它旋转 $m\theta$ :
\[\boldsymbol{R}(m\theta)= \begin{bmatrix} \cos(m\theta) & -\sin(m\theta)\\ \sin(m\theta) & \cos(m\theta) \end{bmatrix}.\]因此,位于位置 $m$ 的 query 和位置 $n$ 的 key 分别变为
\[\tilde{\boldsymbol{q}}_m=\boldsymbol{R}(m\theta)\boldsymbol{q}_m,\qquad \tilde{\boldsymbol{k}}_n=\boldsymbol{R}(n\theta)\boldsymbol{k}_n.\]这里的 $\boldsymbol{q}_m,\boldsymbol{k}_n$ 是内容向量,旋转角度则携带了它们各自的绝对位置信息。
1.2 为什么最终表示的是相对位置
注意力分数由 query 和 key 的内积决定。加入 RoPE 后,有
\[\begin{aligned} \tilde{\boldsymbol{q}}_m^{\mathsf T}\tilde{\boldsymbol{k}}_n &=(\boldsymbol{R}(m\theta)\boldsymbol{q}_m)^{\mathsf T}(\boldsymbol{R}(n\theta)\boldsymbol{k}_n)\\ &=\boldsymbol{q}_m^{\mathsf T}\boldsymbol{R}(m\theta)^{\mathsf T}\boldsymbol{R}(n\theta)\boldsymbol{k}_n\\ &=\boldsymbol{q}_m^{\mathsf T}\boldsymbol{R}((n-m)\theta)\boldsymbol{k}_n. \end{aligned}\]其中用到了旋转矩阵的两个性质:
\[\boldsymbol{R}(\alpha)^{\mathsf T}=\boldsymbol{R}(-\alpha),\qquad \boldsymbol{R}(\alpha)\boldsymbol{R}(\beta)=\boldsymbol{R}(\alpha+\beta).\]可以看到,最终的注意力分数不再分别依赖 $m$ 和 $n$ ,而只依赖两者的相对距离 $n-m$ 。这正是 RoPE 巧妙之处:用绝对位置对应的旋转,得到只依赖相对位置的内积。
继续把上面的式子展开。
记 $\boldsymbol{k}_n^\perp$ 为 $\boldsymbol{k}_n$ 逆时针旋转 $90^\circ$ 后的向量(即 $(-k_2,k_1)$ ),利用
\[\begin{aligned} \boldsymbol{R}(\Delta)\boldsymbol{k} &=\begin{bmatrix} \cos(\Delta) & -\sin(\Delta)\\ \sin(\Delta) & \cos(\Delta) \end{bmatrix}\begin{bmatrix} k_1\\ k_2\end{bmatrix}\\ &=\begin{bmatrix}k_1\cos\Delta-k_2\sin\Delta\\ k_1\sin\Delta+k_2\cos\Delta\end{bmatrix}\\ &=\begin{bmatrix} k_1 \\ k_2 \end{bmatrix}\cos\Delta + \begin{bmatrix} -k_2\\ k_1\end{bmatrix}\sin\Delta\\ &= \boldsymbol{k}\cos\Delta+\boldsymbol{k}^\perp\sin\Delta \end{aligned},\]可以得到
\[\begin{aligned} \langle \tilde{\boldsymbol{q}}_m,\tilde{\boldsymbol{k}}_n\rangle &=\boldsymbol{q}_m^{\mathsf T}\boldsymbol{R}((n-m)\theta)\boldsymbol{k}_n\\ &=\boldsymbol{q}_m^{\mathsf T}\left (\boldsymbol{k}_n\cos((n-m)\theta)+\boldsymbol{k}_n^\perp\sin((n-m)\theta)\right )\\ &=\underbrace{\langle \boldsymbol{q}_m,\boldsymbol{k}_n\rangle}_{\text{内容相似度}}\cos\bigl((n-m)\theta\bigr) +\underbrace{\langle \boldsymbol{q}_m,\boldsymbol{k}_n^\perp\rangle}_{\text{正交分量}}\sin\bigl((n-m)\theta\bigr). \end{aligned}\]这样就一目了然:
- 当 $m=n$ 时, $\cos 0=1, \sin 0=0$ ,分数退化为纯内容相似度,位置不干扰内容匹配;
- 距离拉开时, $\cos$ 项给内容相似度乘上一个随距离起伏的权重, $\sin$ 项掺入一个与内容正交的分量;
- 所以 RoPE 没有把位置加到分数上,而是用相对距离去调制内容匹配的结果——位置是乘性门控,不是加性偏置。
1.3 扩展到高维向量
实际模型中的 head dimension 通常为偶数 $d$ 。RoPE 将向量按两维一组,给第 $i$ 组使用不同频率
\[\theta_i=10000^{-2(i-1)/d},\qquad i=1,\ldots,\frac d2.\]整体旋转矩阵是一个分块对角矩阵:
\[\boldsymbol{R}_m=\mathrm{diag}\bigl( \boldsymbol{R}(m\theta_1),\boldsymbol{R}(m\theta_2),\ldots,\boldsymbol{R}(m\theta_{\frac{d}{2}}) \bigr).\]于是标准缩放点积注意力写成
\[s(m,n) =\frac{(\boldsymbol{R}_m\boldsymbol{q}_m)^{\mathsf T}(\boldsymbol{R}_n\boldsymbol{k}_n)}{\sqrt d} =\frac{\boldsymbol{q}_m^{\mathsf T}\boldsymbol{R}_{n-m}\boldsymbol{k}_n}{\sqrt d}.\]也可以写成展开的形式:
\[s(m,n) =\frac{1}{\sqrt{d}} \sum_{i=1}^{d/2} \left(q_m^{(i)}\right)^\top \boldsymbol{R}\!\left((n-m)\theta_i\right) k_n^{(i)}.\]随后加上因果掩码(不可见位置置 $-\infty$ ),再经 softmax 得到注意力权重 $\alpha(m,n)=\mathrm{softmax}_ns(m,n)$ 。
1.4 直观理解
(a)复数视角:位置就是相位
把每两个维度看成复平面上的一根指针 $z=x_1+\mathrm{i}x_2$ 。乘以 $e^{\mathrm{i}m\theta}$ 就是把指针逆时针转动 $m\theta$ :
\[z^{(m)}=z\ e^{\mathrm{i}m\theta}.\]于是指针的绝对角度(相位)唯一地携带了绝对位置 $m$ 。到这里为止,RoPE 注入的还是绝对信息。
真正的关键在内积的复数写法。实内积等于 $\langle \tilde{\boldsymbol{q}}_m,\tilde{\boldsymbol{k}}_n\rangle=\mathrm{Re}\bigl(z^{(m)}_q\overline{z^{(n)}_k}\bigr)$ , 注意第二个因子要取共轭,共轭把相位取反: $e^{\mathrm{i}n\theta}\to e^{-\mathrm{i}n\theta}$ 。因此
\[z^{(m)}_q\overline{z^{(n)}_k} =\bigl(z_q\overline{z_k}\bigr)e^{\mathrm{i}m\theta}e^{-\mathrm{i}n\theta} =\bigl(z_q\overline{z_k}\bigr)e^{\mathrm{i}(m-n)\theta}.\]两个绝对相位 $m\theta$ 与 $n\theta$ 在相乘时只剩下相位差 $(m-n)\theta$ ,实现了“绝对进、相对出”。
(b)几何视角:只转弯,不改长度
旋转是刚体运动,模长一致: $\lVert\boldsymbol{R}_m\boldsymbol{x}\rVert_2=\lVert\boldsymbol{x}\rVert_2$ 。 RoPE 不会像加性位置编码那样扰动 query/key 的模长与数值分布,它只改变向量的朝向,而朝向正是内积所度量的东西。
(c)多频率
$d/2$ 组维度就是 $d/2$ 根转速不同的指针( $\theta_i=10000^{-2(i-1)/d}$ ):
- 高频指针转得快,相邻位置也有明显相位差,分辨率高、能精细区分近邻;但转过一整圈后相位开始复用,长距离上会出现周期性混叠。
- 低频指针转得慢,在很长距离上都近似单调变化,能覆盖长程依赖,但近处区分度低。
但是问题也在这里埋下了:这既是 RoPE 表达力的来源,也是后文长上下文振荡与混叠的根源。
(d)为什么 value 不需要旋转
位置信息的目标只是决定“关注谁”,而这个决定已经完整编码在注意力权重 $\alpha_{mn}$ 里;输出 $\sum_n\alpha_{mn}\boldsymbol{v}_n$ 通过权重就已经带上了相对位置。若再旋转 value,一是位置信息被重复注入,二是会改变输出表征空间的朝向,与残差、FFN 及后续层所期望的分布不一致。
2. 重新审视 RoPE:怎么失灵了
当我们重新审视 RoPE,会发现其位置信息依赖于频率 $\theta_i$ ,训练时模型只见过特定范围内的位置索引(如 4k)。而当推理长度超过训练长度时,外推改变了相对距离及多频率相位组合的分布,导致注意力分数出现剧烈震荡或完全崩溃。这就是长度泛化的问题,在更长的上下文中可能需要依赖额外的插值算法(如 YaRN)来强行压缩频率空间,这本质上是一种有损的修补,且需要重新微调或校准。
此外,论文 RoPE Distinguishes Neither Positions Nor Tokens in Long Contexts, Provably 提出了一个更强的观点:当上下文不断增长时,RoPE 可能同时失去可靠区分位置和稳定区分 token 的能力;只调整 RoPE base,无法同时解决这两个问题。
2.1 从旋转矩阵到振荡信号
回顾刚刚给出的二维 RoPE 展开: $\langle \tilde{\boldsymbol{q}}_m,\tilde{\boldsymbol{k}}_n\rangle=\langle \boldsymbol{q}_m,\boldsymbol{k}_n\rangle\cos\bigl((n-m)\theta\bigr) +\langle \boldsymbol{q}_m,\boldsymbol{k}_n^\perp\rangle\sin\bigl((n-m)\theta\bigr)$ .
把 $\langle \boldsymbol{q}_m,\boldsymbol{k}_n\rangle$ 和 $\langle \boldsymbol{q}_m,\boldsymbol{k}_n^\perp\rangle$ 分别记作 $A$ 和 $D$ ,则有
\[\begin{aligned} \langle \tilde{\boldsymbol{q}}_m,\tilde{\boldsymbol{k}}_n\rangle &=A\cos\bigl((n-m)\theta\bigr)+D\sin\bigl((n-m)\theta\bigr)\\ &=C\cos\bigl((n-m)\theta-\phi\bigr)\\ \end{aligned}, \begin{aligned} \phi&=\arctan2(D,A)\\ C&=\sqrt{A^2+D^2} \end{aligned}\]其中 $A$ , $D$ , $\phi$ 都是只和 query 和 key 的内容有关,而和位置无关的参数。
我们把二维的公式拓展到 $d=2h$ 维,把 query 与 key 的相对距离记为 $r$ 。每两个维度合并后,RoPE 作用下的未归一化注意力分数就可以写成
\[s_{\boldsymbol{q},\boldsymbol{k}}(r) =\sum_{n=1}^{h}C_n\cos(r\theta_n-\phi_n).\]$\theta_n=B^{-(n-1)/h}$ 由 RoPE base $B$ 决定。也就是说,RoPE attention score 本质上是许多不同频率余弦波的叠加。
接下来我们尝试把这些余弦波按照在上下文长度 $L$ 内转得快还是慢分成两堆。
对第 $n$ 个分量,随相对距离 $r$ 增大,相位从 $\phi_n$ 变成 $r\theta_n - \phi_n$ . 可以想成单位圆上一个点:每拉开 1 个 token,就多转 $\theta_n$ 弧度。
- 如果存在 $r < L$ 使得 $r\theta_n \gtrsim 2\pi$ ,则这个分量至少转完一圈, $\cos$ 会上下摆动很多次。
- 而如果所有 $r$ 都有 $r\theta_n \ll \pi$ ,则这个分量只扫过一小段圆弧, $\cos$ 值几乎单调缓降。
在上下文长度 $L$ 内刚好转满一圈的临界条件是
\[L \cdot \theta_n \approx 2\pi \quad\Longrightarrow\quad L \cdot B^{-(n-1)/h} \approx 2\pi \Longrightarrow n \approx h \log_B\!\frac{L}{2\pi} = \Theta(h\log_B L).\]记 $\lambda(L)=\Theta(h\log_B L)$ :
- $n \ll \lambda(L)$ :转得比一圈还多 → 高频项旋转快,可以区分相邻位置,但也会使分数随距离剧烈振荡。
- $n \gg \lambda(L)$ :转一个非常小的角度 → 低频项旋转慢,形成偏好近距离 token 的衰减趋势,同时让 token 相关性的排序更加稳定。
论文的关键分析是:当距离 $r$ 从一个足够长的区间中采样时,可以借助中心极限定理,把这个余弦和近似看成正态随机变量
\[\tilde{s}_{\boldsymbol{q},\boldsymbol{k}}\sim \mathcal N\left(\mu_L,\sigma_L^2\right),\]其中均值 $\mu_L$ 主要由尚未充分旋转的低频项决定,方差 $\sigma_L^2$ 主要由不断振荡的高频项决定。随着上下文长度 $L$ 增大,低频项越来越少、振荡项越来越多,因此整体表现为均值衰减、方差增大,注意力分数也越来越难预测。
推导过程大致概括如下,严谨的证明推荐去看原论文。
当 $\boldsymbol{q},\boldsymbol{k}$ 固定后, $C_n,\phi_n$ 就定了, $s(r)$ 只是 $\boldsymbol{q}$ 和 $\boldsymbol{k}$ 的相对距离 $r$ 的函数:
\[s(r)=\sum_{n=1}^{h} \underbrace{C_n\cos(r\theta_n-\phi_n)}_{\Psi_n(r)}.\]我们尝试描述距离 $r$ 的分布是在上下文长度 $[0,L)$ 上均匀分布的。那么每个 $\Psi_n$ 就是一个随机变量,从而 $s$ 也是随机变量。所以问题变成: $s$ 的分布长什么样?
我们先看高频项,高频项给我一种“洗匀”的感觉。当 $n \ll \lambda(L)$ , $\theta_n$ 较大,当 $r$ 跑遍 $[0,L)$ 时, $\beta(r) = r\theta_n - \phi_n$ 会绕单位圆转很多很多圈。于是 $\cos\beta(r)$ 把 $[-1,1]$ 上每个取值都扫过很多次。也就是说,从随机抽 $r$ 的角度看,相位 $\beta$ 近似均匀分布在 $[0,2\pi)$ ,概率密度 $p(\beta)\approx\frac{1}{2\pi},\quad 0\le \beta < 2\pi$
可以得到:
\[\begin{aligned} \mathbb{E}[\cos\beta]&\approx\int_{0}^{2\pi}\cos\beta \cdot \frac{1}{2\pi}d\beta=0\\ \mathbb{E}\left[\cos^2\beta\right] &\approx\int_{0}^{2\pi}\cos^2\beta \cdot \frac{1}{2\pi}d\beta \\ &=\frac{1}{2\pi}\int_{0}^{2\pi}\frac{1+\cos2\beta}{2}d\beta \\ &=\frac{1}{4\pi}\left(2\pi+\left.\frac12\sin2\beta\right|_{0}^{2\pi}\right) \\ &=\frac12 \end{aligned}\]所以每个高频项
\[\mathbb{E}[\Psi_n]\approx 0,\qquad \mathrm{Var}(\Psi_n)\approx \frac{C_n^2}{2}.\]转得越快,越像噪声:对均值几乎没有贡献,只贡献波动。
论文里用 Dirichlet Kernel 证明: $r$ 在长区间上均匀时, $\mathbb{E}[\Psi_n]=O(\frac{2C_n}{L\theta_n})\to 0$ , $\mathbb{E}[\Psi_n^2]\to C_n^2/2$ 。
再看低频项,低频项给我一种“冰冻”的感觉。当 $n \gg \lambda(L)$ , $\theta_n$ 很小, $r\in[0,L)$ 时 $r\theta_n$ 扫过的角度非常小(O(1)):
\[r\theta_n-\phi_n \approx -\phi_n,\qquad \cos(r\theta_n-\phi_n)\approx \cos(-\phi_n)=\cos\phi_n.\]也就是说这个余弦几乎不随 $r$ 变,像一个常数:
\[\mathbb{E}[\Psi_n]\approx C_n\cos\phi_n,\qquad \mathrm{Var}(\Psi_n)\approx 0.\]转得越慢,越像常数:抬高或压低整体水平(均值),不制造波动。
此时我们注意到:
(a) 各频率项近似独立。 $\theta_1=B^{0/h}=1$ , $\theta_n=B^{-(n-1)/h}=\theta^{n-1}$ ,序列 $1,\theta,\theta^2,\ldots$ 在有理数集 $\mathbb{Q}$ 上几乎线性无关(Weyl 等分布准则),于是 $r\theta_n \bmod 2\pi$ 对不同 $n$ 近似独立均匀。论文估计协方差 $\mathrm{Cov}[\Psi_n\Psi_p]=O(\frac{C_nC_p}{L\theta_n})$ ,高频时极小可忽略。
(b) 中心极限定理。 高频项 $\sum_{n<\lambda(L)} C_n\cos(r\theta_n-\phi_n)$ 是许多独立、均值为 0、无单项主导的随机项之和,渐近正态。Berry–Esseen 给出误差 $O(1/\sqrt{\lambda(L)})$ 。
再加上低频项近似常数,整体就是:
\[\boxed{ \tilde{s} \sim \mathcal{N}(\mu_L,\ \sigma_L^2),\quad \mu_L \approx \sum_{n\ge\lambda(L)} C_n\cos\phi_n,\quad \sigma_L^2 \approx \frac12\sum_{n<\lambda(L)} C_n^2 }\]均值由低频决定,方差由高频决定。
论文给出了一个正态分布拟合注意力分数的图.
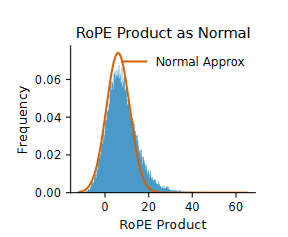
使用正态分布拟合注意力分数,图片来源:RoPE Distinguishes Neither Positions Nor Tokens in Long Contexts, Provably
2.2 四种失败模式
| 现象 | 数学表现 | 直观含义 |
|---|---|---|
| 位置反转 | $r_1<r_2$ ,但 $s(r_1)<s(r_2)$ | 同一个 token 放得更远,注意力分数反而更高,局部性偏置失效 |
| 位置混叠 | $r_1\ne r_2$ ,但 $s(r_1)=s(r_2)$ | 不同位置产生相同分数,模型无法仅凭该分数区分位置 |
| token 反转 | $s_1(0)>s_2(0)$ ,但某个 $r$ 上 $s_1(r)<s_2(r)$ | 两个 token 原本的相关性排序被距离反转 |
| token 混叠 | $\boldsymbol{k}_1\ne\boldsymbol{k}_2$ ,但 $s_1(r)=s_2(r)$ | 不同 token 在某个位置得到相同分数 |
当上下文 $L$ 进一步变长时, $\lambda(L)=\Theta(h\log_B L)$ 变大,更多项从低频常数被划进高频噪声: $\mu$ 稳定项变少, $\sigma^2$ 变大,论文证明了两种“反转”的概率下界最终都可趋近 $0.5$ ,即排序接近抛硬币猜测;两种“混叠”还会受到 BF16 等有限数值精度的放大。
2.3 RoPE base 不是免费的午餐
增大 base $B$ 会让各维度旋转得更慢。这有助于稳定不同 token 的相关性排序,缓解 token 反转和 token 混叠;但不同位置之间的相位差也会变小,从而加重位置反转和位置混叠。较大的 base 更有利于区分 token,却更不利于区分位置;较小的 base 则相反。
因此,位置插值、NTK scaling 或单纯增大 base 更像是在两类误差之间重新分配预算,而不是从根本上消除长上下文问题。
3. NoPE:不显式注入位置信息,模型可以隐式地学习到位置吗
既然显式位置编码 RoPE 会把模型锁死在训练时见过的旋转角里,那么如果不使用位置编码,模型会不会自行学习到隐式的位置信息呢?
这是一个很反直觉的现象:最开始设计 Transformer 的时候就引入了位置编码,因为 Attention 机制的设计天然不具有位置信息,那为什么又要重新尝试 NoPE (No Positional Encoding) 呢?
首先需要澄清的是,Encoder 里的自注意力对位置是不敏感的。所以 BERT 一旦去掉位置编码,就退化成词袋模型。
但 decoder-only 不一样,核心就是 causal mask,因果掩码打破了置换对称性:位置 $t$ 的 query 只能看到 $1,\ldots,t$ 这些位置的 key。也就是说,能看到多少个历史 token,可能本身编码了位置信息。
论文 The Impact of Positional Encoding on Length Generalization in Transformers 证明,NoPE 这种隐式位置不仅能学习到绝对位置,也能学习到相对位置,同时系统对比了 APE、T5 Relative Bias、ALiBi、RoPE 和 NoPE,结论如下:
- 在长度泛化的算法任务上,NoPE 与最强的显式方案 T5 Relative Bias 打平,甚至更好;
- 而 RoPE 的表现反而更接近 APE,长度外推并不理想。
3.1 NoPE 怎么学到绝对位置
论文的 Theorem 1 :
对输入 $\boldsymbol{x}=[\langle \mathrm{bos}\rangle, x_2,\ldots,x_{T+1}]^T$ ,NoPE 的第一层存在一组参数,使得隐状态 $\boldsymbol{H}^{(1)}$ 中恢复出绝对位置 $[1,\ldots,T+1]$ 。也就是说,我们可以找出一组 $\boldsymbol{W}_Q, \boldsymbol{W}_K, \boldsymbol{W}_V, \boldsymbol{W}_O, \boldsymbol{W}_1, \boldsymbol{W}_2$ 使得可以把第一层恢复的绝对位置写入到下一层的隐状态。
证明是构造性的,仅需使用隐藏状态的前三个维度。其余的注意力头只要不覆盖前三个维度,其具体形式可以是任意的。这在实践中并不会带来任何困难,因为实际使用的 Transformer 模型通常具有非常大的模型维度。
第一步,用 embedding 埋两个锚点
把隐状态的前三个维度先预留出来:
- 第 1 维:所有 token 都置为 $1$ (常数);
- 第 2 维:仅当 token 是 $\langle \mathrm{bos}\rangle$ 时为 $1$ ,否则为 $0$ ; 这里不妨假设 $\langle \mathrm{bos}\rangle$ 的 token id 是 $1$ ;
- 第 3 维:初始为 $0$ ,留给注意力往里写位置;
- 其它维:其余维度不受影响。
也就是词嵌入矩阵形如
\[\boldsymbol{W}_E= \begin{bmatrix} 1 & 1 & 1 & \cdots & 1\\ 1 & 0 & 0 & \cdots & 0\\ 0 & 0 & 0 & \cdots & 0\\ e_{4,1} & e_{4,2} & e_{4,3} & \cdots & e_{4,V}\\ \vdots & \vdots & \vdots & \ddots & \vdots \end{bmatrix}_{d\times V}.\]$d$ 代表隐状态维度, $V$ 代表词表大小。
第二步,让注意力均匀数数
取一个注意力头,参数设计成这样,因为实践中基本都使用多头注意力,所以设计一个 head 就够了,其他 head 只要不覆盖这前三维就可以:
- $\boldsymbol{W}_K$ 只读第 1 维 → 所有 key 完全相同;
- $\boldsymbol{W}_V$ 只读第 2 维 → 只有 $\langle \mathrm{bos}\rangle$ 的 value 是 $1$ ,其余都是 $0$ ;
- $\boldsymbol{W}_Q$ 随意, $\boldsymbol{W}_O$ 把结果写回第 3 维。
$h$ 代表注意力一个头的维度。
把输入序列写成 one-hot 矩阵
\[\boldsymbol{X}=[\boldsymbol{x}_1, \boldsymbol{x}_2,\ldots,\boldsymbol{x}_{T+1}]\in\mathbb{R}^{V\times(T+1)},\]每一列是一个 token 的 one-hot 向量,第 $t$ 列 $\boldsymbol{x}_t$ 位于绝对位置 $t$ ,其中首列 $\boldsymbol{x}_1$ 就是 $\langle \mathrm{bos}\rangle$ 的 one-hot 向量。左乘 $\boldsymbol{W}_E$ 得到隐状态 $\boldsymbol{H}^{(0)}$ 。因为 $\boldsymbol{x}_t$ 是 one-hot,这一步本质上就是把 $\boldsymbol{W}_E$ 的列按 token 的词表 id 重新排列;把 $\text{id}(\boldsymbol{x}_t)$ 记作第 $t$ 个 token 对应的词表 id,则有 $\text{id}(\boldsymbol{x}_1)=\text{id}(\langle \mathrm{bos}\rangle)=1$ 。
\[\boldsymbol{H}^{(0)}=\boldsymbol{W}_E\boldsymbol{X} =\begin{bmatrix} 1 & 1 & 1 & \cdots & 1\\ 1 & 0 & 0 & \cdots & 0\\ 0 & 0 & 0 & \cdots & 0\\ e_{4,1} & e_{4,2} & e_{4,3} & \cdots & e_{4,V}\\ \vdots & \vdots & \vdots & \ddots & \vdots \end{bmatrix} \begin{bmatrix} \boldsymbol{x}_1 & \boldsymbol{x}_2 & \cdots & \boldsymbol{x}_{T+1} \end{bmatrix} =\begin{bmatrix} 1 & 1 & 1 & \cdots & 1\\ 1 & 0 & 0 & \cdots & 0\\ 0 & 0 & 0 & \cdots & 0\\ e_{4,1} & e_{4,\text{id}(\boldsymbol{x}_2)} & e_{4,\text{id}(\boldsymbol{x}_3)} & \cdots & e_{4,\text{id}(\boldsymbol{x}_{T+1})}\\ \vdots & \vdots & \vdots & \ddots & \vdots \end{bmatrix}_{d\times (T+1)}.\]接下来计算 $\boldsymbol{K}$ 矩阵:
\[\boldsymbol{K}=\boldsymbol{W}_K\boldsymbol{H}^{(0)}=\begin{bmatrix} 1 & 0 & \cdots & 0\\ 1 & 0 & \cdots & 0\\ \vdots & \vdots & \ddots & \vdots\\ 1 & 0 & \cdots & 0 \end{bmatrix} \begin{bmatrix} 1 & 1 & 1 & \cdots & 1\\ 1 & 0 & 0 & \cdots & 0\\ 0 & 0 & 0 & \cdots & 0\\ e_{4,1} & e_{4,\text{id}(\boldsymbol{x}_2)} & e_{4,\text{id}(\boldsymbol{x}_3)} & \cdots & e_{4,\text{id}(\boldsymbol{x}_{T+1})}\\ \vdots & \vdots & \vdots & \ddots & \vdots \end{bmatrix} =\begin{bmatrix} 1 & 1 & \cdots & 1\\ 1 & 1 & \cdots & 1\\ \vdots & \vdots & \ddots & \vdots\\ 1 & 1 & \cdots & 1 \end{bmatrix}_{h\times (T+1)}.\]$\boldsymbol{W}_Q$ 可以任意取,所以不妨直接考察位于绝对位置 $t\in[1,T+1]$ 的 query: $\boldsymbol{q}_t=\boldsymbol{W}_Q\boldsymbol{h}_t^{(0)}=[q_1,\cdots,q_h]^T\in\mathbb{R}^{h\times 1}$ 。在 causal mask 下,位置 $t$ 的 query 只能与 $i\le t$ 的 key 交互,也就是说它恰好能看见自己以及之前的全部 $t$ 个 token,其中就包含位于位置 $1$ 的 $\langle\mathrm{bos}\rangle$ 。把这 $t$ 个可见 key 按列拼成
\[\boldsymbol{K}_t=\begin{bmatrix} \boldsymbol{k}_1, \boldsymbol{k}_2, \cdots, \boldsymbol{k}_t \end{bmatrix}=\boldsymbol{1}_{h\times t}.\]忽略 $1/\sqrt{d}$ ,由于所有 key 完全相同,未归一化的注意力分数也都相同:
\[\boldsymbol{s}_t=\boldsymbol{K}_t^{\mathsf T}\boldsymbol{q}_t=\boldsymbol{1}_{t\times h}\begin{bmatrix} q_1 \\ q_2 \\ \vdots \\ q_h \end{bmatrix} =\begin{bmatrix} \sum_i q_i\\ \sum_i q_i\\ \vdots\\ \sum_i q_i \end{bmatrix}_{t\times 1}.\]于是经过 softmax 给出均匀分布:
\[\boldsymbol{\alpha}_t=\mathrm{softmax}(\boldsymbol{s}_t)=\Bigl[\frac1t,\frac1t,\ldots,\frac1t\Bigr]^T.\]计算 $\boldsymbol{V}$ 矩阵:
\[\boldsymbol{V}=\boldsymbol{W}_V\boldsymbol{H}^{(0)}=\begin{bmatrix} 0 & 1 & 0 & \cdots & 0\\ 0 & 0 & 0 & \cdots & 0\\ \vdots & \vdots & \vdots & \ddots & \vdots\\ 0 & 0 & 0 & \cdots & 0 \end{bmatrix} \begin{bmatrix} 1 & 1 & 1 & \cdots & 1\\ 1 & 0 & 0 & \cdots & 0\\ 0 & 0 & 0 & \cdots & 0\\ e_{4,1} & e_{4,\text{id}(\boldsymbol{x}_2)} & e_{4,\text{id}(\boldsymbol{x}_3)} & \cdots & e_{4,\text{id}(\boldsymbol{x}_{T+1})}\\ \vdots & \vdots & \vdots & \ddots & \vdots \end{bmatrix} =\begin{bmatrix} 1 & 0 & 0 & \cdots & 0\\ 0 & 0 & 0 & \cdots & 0\\ 0 & 0 & 0 & \cdots & 0\\ \vdots & \vdots & \vdots & \ddots & \vdots\\ 0 & 0 & 0 & \cdots & 0 \end{bmatrix}_{h\times (T+1)}.\]其中
\[\boldsymbol{V}_t=\begin{bmatrix} \boldsymbol{v}_1, \boldsymbol{v}_2, \cdots, \boldsymbol{v}_t \end{bmatrix},\]取 $\boldsymbol{V}$ 的前 $t$ 列。由于 $\langle\mathrm{bos}\rangle$ 位于位置 $1$ , $\boldsymbol{V}$ 唯一的非零列就是
\[\boldsymbol{v}_1=\begin{bmatrix}1 & 0 & \cdots & 0\end{bmatrix}^T,\]而 $\boldsymbol{v}_2,\ldots,\boldsymbol{v}_t$ 都是 $\boldsymbol{0}$ 向量。
再对 value 加权求和,只有 $\langle \mathrm{bos}\rangle$ 贡献了 $1$ ,所以
\[\hat{\boldsymbol{o}}_t=\sum_{i\le t}\alpha_{t,i}\boldsymbol{v}_i =\frac{1}{t}\sum_{i\le t}\boldsymbol{v}_i=\begin{bmatrix} \frac{1}{t} \\ 0 \\ \vdots \\ 0 \end{bmatrix}.\]最后经过 $\boldsymbol{W}_O$ 矩阵,得到绝对位置 $t$ 处这个 query 的注意力输出:
\[\boldsymbol{o}_t=\boldsymbol{W}_O\hat{\boldsymbol{o}}_t=\begin{bmatrix} 0 & 0 & 0 & \cdots & 0\\ 0 & 0 & 0 & \cdots & 0\\ 1 & 0 & 0 & \cdots & 0\\ 0 & 0 & 0 & \cdots & 0\\ \vdots & \vdots & \vdots & \ddots & \vdots\\ 0 & 0 & 0 & \cdots & 0 \end{bmatrix}\begin{bmatrix} \frac{1}{t} \\ 0 \\ \vdots \\ 0 \end{bmatrix}=\begin{bmatrix} 0 \\ 0 \\ \frac{1}{t} \\ 0 \\ \vdots \\ 0 \end{bmatrix}.\]注意力输出的第 3 维,恰好是绝对位置 $t$ 的倒数 $1/t$ 。( $t=1$ 时 $\langle\mathrm{bos}\rangle$ 只看见自己,得到 $1$ 。)
第三步,用 FFN 把 $1/t$ 还原成 $t$
第一层的前馈网络是带 ReLU 的 MLP,足够宽时可以逼近任意函数,因此完全可以学出映射
\[\frac1t \;\longmapsto\; t.\]于是从第二层开始,残差流里就合法地躺着每个 token 的绝对位置。
这个构造里有两个关键点:
- causal mask:让绝对位置 $t$ 上的 query 恰好能看见 $t$ 个 key,把“可见长度”变成位置计数器;
- $\langle \mathrm{bos}\rangle$ (或任意锚点 token): 打破平移对称,给计数提供原点;实际使用中的 instruction / prompt 就在扮演这个角色
3.2 NoPE 怎么学到相对位置
论文 Theorem 2:
若 $\boldsymbol{H}^{(1)}$ 中已含有绝对位置(且不被后续层覆盖),则 $l\ge 2$ 的自注意力可以实现相对位置编码:存在参数化使得
\[\langle \boldsymbol{q}_t, \boldsymbol{k}_i\rangle = f_{\mathrm{content}}(\boldsymbol{q}_t,\boldsymbol{k}_i) + f_{\mathrm{relative}}(t-i).\]
构造同样只需要很少几个维度。
令第二层及之后的
\[\boldsymbol{W}_Q=\begin{bmatrix} 1 & 0 & 0 & 0 & \cdots & 0\\ 0 & 0 & -1 & 0 & \cdots & 0\\ w_{3,1} & w_{3,2} & w_{3,3} & w_{3,4} & \cdots & w_{3,h}\\ \vdots & \vdots & \vdots & \vdots & \ddots & \vdots\\ \end{bmatrix}_{h\times d}, \boldsymbol{W}_K =\begin{bmatrix} 0 & 0 & 1 & 0 & \cdots & 0\\ 1 & 0 & 0 & 0 & \cdots & 0\\ w_{3,1}' & w_{3,2}' & w_{3,3}' & w_{3,4}' & \cdots & w_{3,h}'\\ \vdots & \vdots & \vdots & \vdots & \ddots & \vdots\\ \end{bmatrix}_{h\times d}.\]$\boldsymbol{W}_Q, \boldsymbol{W}_K$ 矩阵除了前两个维度以外都可以是任意值, $\boldsymbol{W}_V, \boldsymbol{W}_O$ 可以是任意的只要不覆盖前三维。
之前证明了在该构造方法下 NoPE 把学到的绝对位置信息放在了第三维,不妨假设第 $l(l\ge2)$ 层隐状态
\[\boldsymbol{H}^{(l)}=\begin{bmatrix} 1 & 1 & 1 & \cdots & 1\\ 1 & 0 & 0 & \cdots & 0\\ 1 & 2 & 3 & \cdots & T+1\\ h_{4,1} & h_{4,2} & h_{4,3} & \cdots & h_{4,T+1}\\ \vdots & \vdots & \vdots & \ddots & \vdots \end{bmatrix}_{d\times (T+1)}.\]同样的,除了前三维度其余可以是任意值,我们还是同样考察位置 $t$ 的 $\boldsymbol{q}_t$ :
\[\boldsymbol{q}_t = \boldsymbol{W}_Q\boldsymbol{h}_t^{(l)}=\begin{bmatrix} 1 & 0 & 0 & 0 & \cdots & 0\\ 0 & 0 & -1 & 0 & \cdots & 0\\ w_{3,1} & w_{3,2} & w_{3,3} & w_{3,4} & \cdots & w_{3,h}\\ \vdots & \vdots & \vdots & \vdots & \ddots & \vdots\\ \end{bmatrix} \begin{bmatrix} 1\\ 0\\ t\\ h_{4,t}\\ \vdots \end{bmatrix} =\begin{bmatrix} 1\\ -t\\ q_3\\ \vdots \end{bmatrix}.\]$q_j\in \mathbb{R}$ .
然后我们计算 $\boldsymbol{k}_i$ :
\[\boldsymbol{k}_i=\boldsymbol{W}_K\boldsymbol{h}_i^{(l)}=\begin{bmatrix} 0 & 0 & 1 & 0 & \cdots & 0\\ 1 & 0 & 0 & 0 & \cdots & 0\\ w_{3,1}' & w_{3,2}' & w_{3,3}' & w_{3,4}' & \cdots & w_{3,h}'\\ \vdots & \vdots & \vdots & \vdots & \ddots & \vdots\\ \end{bmatrix} \begin{bmatrix} 1 \\ 0 \\ i \\ h_{4,i} \\ \vdots \end{bmatrix} =\begin{bmatrix} i \\ 1 \\ k_{3,i} \\ \vdots \end{bmatrix}\]$k_{j,i}\in \mathbb{R}$ .
现在就可以对内积直接拆开:
\[\begin{aligned} \langle \boldsymbol{q}_t, \boldsymbol{k}_i\rangle &= \underbrace{\begin{bmatrix} 1 & -t & q_3 & \cdots \end{bmatrix}}_{\boldsymbol{q}_t^{\mathsf T}}\; \underbrace{\begin{bmatrix} i \\ 1 \\ k_{3,i} \\ \vdots \end{bmatrix}}_{\boldsymbol{k}_i}= 1\cdot i + (-t)\cdot 1 + \sum_{j=3}^{h} q_j k_{j,i}\\ &= \underbrace{\sum_{j=3}^{h} q_j k_{j,i}}_{f_{\mathrm{content}}(\boldsymbol{q},\boldsymbol{k})} \;+\; \underbrace{(i-t)}_{f_{\mathrm{relative}}(t-i)}. \end{aligned}\]于是注意力分数干净地分成了两项:
- $f_{\mathrm{content}}$ :只和内容有关;
- $f_{\mathrm{relative}}(t-i)=-(t-i)$ :只和相对距离有关。
这和 T5 Relative Bias 把 $f(i-j)$ 加到 logits 上是同一类东西,只不过 NoPE 是自己学出来的,而不是写进架构里。而且论文指出,第一层的 MLP 甚至可以把任意关于绝对位置的函数写进隐状态,所以学到的 $f_{\mathrm{relative}}$ 不必是线性的,可以更复杂。
3.3 界定学到的位置编码模式
理论说既能学到绝对位置,也能学到相对位置,那实际学到的会不会有偏好呢?论文用了一个很聪明的办法:比注意力模式。
对使用不同位置编码得到的模型 $A$ 和 $B$ ,在每一层 $l$ 、每个 head $P\in A, Q\in B$ 上算同位置 $t$ 注意力分布的 Jensen–Shannon 散度,再取两模型间所有 head 对的最小值:
\[D^{(l)}(A,B)=\min_{(P,Q)\in A_l\times B_l}\frac1T\sum_{t=1}^{T}D_{\mathrm{JS}}\bigl(P_t\|Q_t\bigr).\]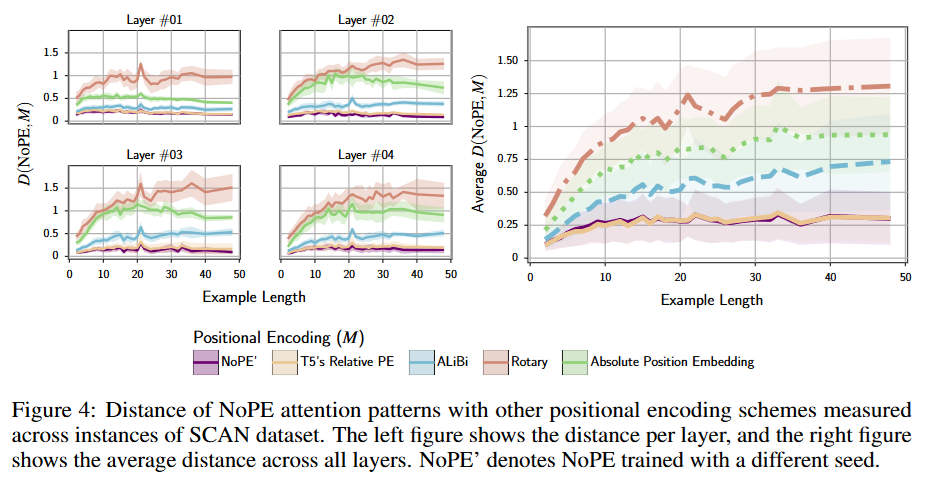
SCAN数据集上,NoPE注意力模式相对于其他位置编码方案的距离。左图是逐层距离,右图为全层平均距离。NoPE’是换随机种子训练的NoPE。图片来源:The Impact of Positional Encoding on Length Generalization in Transformers
两个分布越像, $D_{\mathrm{JS}}$ 越小,而两个分布差异越大,则 $D_{\mathrm{JS}}$ 越大。
通过比较使用 SGD 训练的 NoPE 和其他显式的位置编码,得到如下结果:
- NoPE 最像 T5 Relative PE;
- 最不像 APE 和 RoPE。
也就是说,没有显式位置编码的 decoder,在 SGD 下主要学会了相对位置,类似 T5 那种加性 bias 的形态,而不是 RoPE 那种乘性旋转。
注意力距离的分布也印证了这一点:NoPE 和 T5 RPE 都呈现出“近处 + 远处”的双峰注意力(既有短程依赖,也会回看输入),而 ALiBi 因为 recency bias 强烈偏向近邻,Rotary 则更接近 APE 的均匀分布。
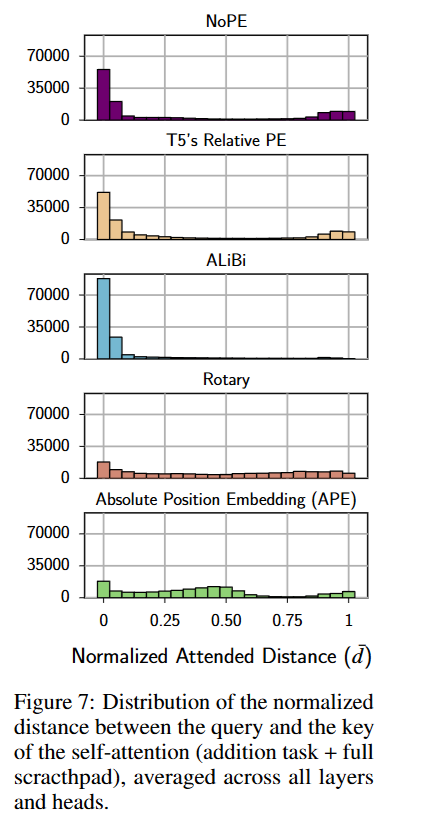
自注意力机制中Query与Key的归一化距离分布(加法任务 + 完整草稿本),在所有层与所有注意力头上取平均。图片来源:The Impact of Positional Encoding on Length Generalization in Transformers
3.4 长度泛化上的表现
论文在 Copy / Reverse / Addition / Polynomial / Sort / Summation / Parity / LEGO / SCAN / PCFG 这批任务上(训练长度 $\le L=20$ ,测试到 $2L$ ): NoPE 和 T5 RPE 打平或更好,剩下的表现都比较一般。
3.5 小结
前三节主要讲了 RoPE, RoPE 出现的问题,以及是否有不使用位置编码的可能:
- RoPE 对 query 和 key 注入绝对位置的旋转,并让二者的内积只依赖相对距离,绝对进、相对出。
- 长上下文暴露了 RoPE 的能力边界。固定频率带来了清晰的局部位置先验,也带来了长距离下不可避免的周期振荡、位置混叠和 token 排序不稳定。
- NoPE 说明显式位置编码并非必要条件。对 decoder-only Transformer 而言,causal mask 已经打破了置换对称性;借助 softmax、锚点 token 和残差流,模型可以隐式地学到位置信息。
结合之前的其他工作, Transformer 获得位置信息大致有三条路径:
- 把位置加进 embedding,如 APE:位置和内容从模型入口开始绑定;
- 用位置调制注意力分数,如 RoPE、T5 和 ALiBi:位置在每层显式参与 token 之间的打分;
- 从因果结构中计算位置,如 NoPE:架构不提供单独的位置项,而由模型从可见前缀和锚点中隐式恢复位置。
RoPE 把有用的相对位置先验直接写进架构,短距离上稳定、明确、易于学习,但固定频率也限制了长度外推;NoPE 没有训练窗口之外的旋转角需要处理,并把位置的表示方式交给优化器,但它依赖模型真正学会一套位置算法。论文中的构造证明了 NoPE 能够表示绝对和相对位置,却不保证有限数据上总能学到最稳健的实现,也不意味着它可以单独支撑任意长的真实文本。
因此,研究者们把目光投向把 RoPE 和 NoPE 结合的尝试,追问哪些计算需要显式的位置几何,哪些计算可以把位置交给模型自己学习?RoPE 又是否必须覆盖每一层、每个 head 和每个维度?
接下来将沿着这个方向介绍两类混合设计:
- 一是 Google 的 p-RoPE: 在维度上只旋转部分通道
- 二是 LLaMA 的 iRoPE:在层之间交错安排 RoPE 与 NoPE
4. p-RoPE:只旋转部分通道
谷歌团队在论文Round and Round We Go! What makes Rotary Positional Encodings useful?给出了 p-RoPE 方法,并且在之后的 Gemma 4 模型中沿用了这个位置编码方法( $p=0.25$ )。其实和之前第二章 重新审视 RoPE:怎么失灵了有相似之处, p-RoPE 设计的起点也是观察到了 RoPE 的不同频率可能在承担不同的工作。 之前的分析认为 RoPE 中高频部分主要是聚焦近邻位置,而低频部分则提供远距离信息。类似地,谷歌团队的分析认为:
- 高频通道对相邻 token 的位移非常敏感,适合构造“当前位置”、“前一个 token”或对角线这样的局部位置模式;
- 低频通道随位置变化得很慢,更适合承载语义相似性,让相距较远但内容相关的 token 仍然能够对齐。
标准 RoPE 把所有通道都旋转,低频语义通道也变成了会随距离漂移的通道。而 p-RoPE 的想法就是:保留高频通道的位置旋转,把最低的一部分频率改为不旋转。
4.1 RoPE 为什么有效
论文从 RoPE 为什么有效开始研究。在苏神的博客中,他给出了一个 RoPE 具有远程衰减性的证明,这也被认为是 RoPE 奏效的关键原因。但是论文的质疑也就从这里开始,苏神给出的证明是一个衰减的上界,论文研究发现该上界的衰减并不能自然带来注意力实际的必然衰减。
论文先证明给定固定的 query ,对应的注意力分数最大的 key 不一定只在近处,可能在任意地方。形式化的说,给定非零的 query $\boldsymbol{q}$ 以及和 key 的相对位置 $\delta\in\mathbb{Z}$ ,存在 $\boldsymbol{k}$ 使得 RoPE 之后该处的注意力分数最大,简单证明如下:
回顾之前的公式,位于位置 $m$ 的 $q$ 和位置 $n$ 的 $k$ 点积注意力, 忽略 $1/\sqrt{d}$ 的系数:
\[s(m,n) =\boldsymbol{q}^{\mathsf T}\boldsymbol{R}^{n-m}\boldsymbol{k}.\]因为 causal mask, $q$ 只能看见前面的 $k$ ,所以 $m\ge n$ ,令相对距离 $r=m-n$ , 则有 $s(r)=\boldsymbol{q}\boldsymbol{R}^{-r}\boldsymbol{k}$ .
那么我们构造 $k=\boldsymbol{R}^{\delta}\boldsymbol{q}$ ,则有
\[s(\delta)=\boldsymbol{q}^{\mathsf T}\boldsymbol{R}^{-\delta}\boldsymbol{k}=\boldsymbol{q}^{\mathsf T}\boldsymbol{R}^{-\delta}\boldsymbol{R}^{\delta}\boldsymbol{q}=\boldsymbol{q}^{\mathsf T}\boldsymbol{q}=\|\boldsymbol{q}\|^2.\]将这个构造的 $k$ 代入到其他任意距离 $r$ 的 $s(r)$ 中,则有
\[\begin{aligned} s(r) &=\boldsymbol{q}^{\mathsf T}\boldsymbol{R}^{-r}\boldsymbol{k}\\ &=\boldsymbol{q}^{\mathsf T}\boldsymbol{R}^{-r}\boldsymbol{R}^{\delta}\boldsymbol{q}\\ &=\boldsymbol{q}^{\mathsf T}\boldsymbol{R}^{\delta-r}\boldsymbol{q}\\ &\le\|\boldsymbol{q}\|\cdot \|\boldsymbol{R}^{\delta-r}\boldsymbol{q}\| \\ &=\|\boldsymbol{q}\|^2=s(\delta). \end{aligned}\]| 最后两步分别使用了 Cauchy–Schwarz 不等式( $ | \langle \boldsymbol{x},\boldsymbol{y}\rangle | \le|\boldsymbol{x}|\cdot|\boldsymbol{y}|$ ) 和旋转矩阵保范数性质。 |
这样我们就证明了目标距离 $\delta$ 处的分数不小于任何其他距离处的分数。
基于此,论文还额外证明了对于从标准正态分布中采样的 $\boldsymbol{q},\boldsymbol{k}\sim \mathcal{N}(0,1)$ ,那么此时相对距离 $r$ 的分数 $s(r)$ 的期望是 0, 此处证明就略过了。
那么到底是什么让 RoPE 奏效呢?
论文分析了 Gemma 7B 的 query 和 key 在各个频率对应的二维块上的范数,得到三个主要发现:
- 整体偏好低频;
- 少数注意力头明显使用高频;
- 频率使用呈现稀疏的高范数条带。
RoPE 的频率本身是设定好了的,这里讨论的是模型通过学习 query、key 的分量来决定各个频率对注意力有多大影响。
忽略 $1/\sqrt d$ 缩放,RoPE 分数可以写为
\[s(m,n)=\sum_{i=1}^{d/2} \underbrace{ \left(q_m^{(i)}\right)^\top \boldsymbol{R}\!\left((n-m)\theta_i\right) k_n^{(i)} }_{\text{第 }i\text{ 个频率的分数贡献}}.\]因此,每个频率都对应一个参与计算分数的二维通道。 当模型在学习中放大了某个频率的 query、key 分量,这个频率就有能力影响注意力分数。 而某个频率对应的 query 和 key 分量都接近零,即使这个频率仍然存在,也几乎不影响结果。
和之前的推导一样,某个频率的贡献 $|s(m,n)^{(i)}|=|\left(q_m^{(i)}\right)^\top \boldsymbol{R}!\left((n-m)\theta_i\right) k_n^{(i)}| \le |q_m^{(i)}|_2|k_n^{(i)}|_2$ 的上限就是 $q$ 和 $k$ 对应的二维块范数。如果对应的二维块范数乘积很小,那这确实可以限制贡献的大小。
论文观察了在模型同一层对各个 head 的二维块范数取平均后,发现低频的二维块范数明显大于高频的,且几乎每一层都表现出这个现象,由此得出第一个结论:模型整体偏好低频。
紧接着,论文观察了同一层不同 head 的二维块范数,发现某些 head 明显使用高频,而其他 head 则几乎不使用,由此得出第二个结论:某些 head 明显使用高频。
同时,论文还注意到单个注意力 head 并不是均匀使用一大片低频,而是会在某些频率上范数特别大,所以才说稀疏性。此外论文还观察了 value 是否出现类似情况,答案是否定的,这才确定是 RoPE 导致的这些现象。
继续研究,论文发现有的头的注意力分数只集中在 query 和其对应位置的 key 上,呈现出一种对角式的注意力,或者只集中在 query 和其前一个 token 的 key 上,呈现出关注前一个 token 的注意力。这两种注意力都需要依赖高频才能体现,否则低频的话本身变化太小。随后论文证明了 NoPE 不能构建出这种对角式和关注前一个 token 的注意力模式,但是 RoPE 可以。
这个结论和上一节对 NoPE 的结论矛盾吗?其实不是,上一节说明了 NoPE 可以通过完整网络逐步学出位置表示,再实现位置型注意力;但没有 RoPE 预先生成的位置表示时,一个孤立的 NoPE 头能不能稳健地区分相同内容的不同位置其实是存疑的。
高频匹配了位置信息,而语义信息聚焦谁的内容符合当前的 query 的要求,无论某个目标 token 在近处还是远处,都希望根据其内容找到它,因此也就适配低频。
对于 RoPE 注意力分数 $s(m,n)$ , 当 $\theta_i$ 很小时, $(n-m)\theta_i\rightarrow0$ ,就有
\[\boldsymbol R\bigl((n-m)\theta_i\bigr)\approx \boldsymbol I,\]这时内积主要反映内容相似性,而不是位置差异。
然而 $\theta_i$ 再小也不是零,只要上下文足够长, $(n-m)\theta_i$ 仍会累积成较大的角度,原本应该稳定的语义通道也可能发生错位,在长上下文中并不真正远程衰减。也就由此引出了 p-RoPE 的想法。
4.2 p-RoPE 的定义
设 $p\in[0,1]$ 表示保留多少比例的 RoPE 频率,令
\[\zeta=\left\lfloor p\frac d2\right\rfloor.\]p-RoPE 只对前 $\zeta$ 个二维通道进行旋转,对剩下的低频通道使用恒等变换:
\[\boldsymbol R_{m}^{(p)} =\mathrm{diag}\left(\underbrace{ \boldsymbol R(m\theta_1), \ldots, \boldsymbol R(m\theta_{\zeta})}_{\zeta \text{ 个}}, \underbrace{\boldsymbol I,\ldots,\boldsymbol I}_{\frac{d}{2}-\zeta\text{ 个}} \right).\]因此,位置 $m$ 和位置 $n$ 之间的注意力分数变成
\[\begin{aligned} s_{m,n}^{(p)} &=\left(\boldsymbol q_m\right)^{\mathsf T} \left(\boldsymbol R_m^{(p)}\right)^{\mathsf T} \boldsymbol R_n^{(p)}\boldsymbol k_n\\ &=\sum_{i=1}^{\zeta} \left(\boldsymbol q_m^{(i)}\right)^{\mathsf T} \boldsymbol R\bigl((n-m)\theta_i\bigr)\boldsymbol k_n^{(i)} +\sum_{i=\zeta+1}^{\frac{d}{2}} \left(\boldsymbol q_m^{(i)}\right)^{\mathsf T}\boldsymbol k_n^{(i)}. \end{aligned}\]前半部分仍然是 RoPE,负责提供显式的位置几何;后半部分不再感知相对距离,可以作为稳定的语义通道。
当 $p=1$ 时,所有通道都旋转,退化为标准 RoPE;而 $p=0$ 时,所有通道都不旋转,退化为 NoPE。
所以 $p$ 可以看成 RoPE 和 NoPE 之间的一个结构插值参数。
4.3 p-RoPE 和增大 base
如果把旋转 base 增大,也可以让一部分通道在更长上下文中变化得更慢,但此时增大相应地也会整体减慢所有频率,原本负责精确位置的高频也会被改变。
而 p-RoPE 则是在一个 head 内明确划分“位置子空间”和“语义子空间”,不必牺牲高频提供的局部位置分辨率,也能为语义匹配留下位置无关的通道。
在实验中,论文使用了 $p=0.75$ ,即保留 75% 的高频通道,剩下 25% 的低频通道被取消。
5. iRoPE:让局部位置和全局检索分层协作
前面 p-RoPE 是在同一个 attention head 的不同维度里混合 RoPE 和 NoPE。iRoPE 则选择了另一个方向:在不同层之间交错使用 RoPE 和 NoPE。
5.1 Llama 4 怎么使用 iRoPE
现在很多大模型都使用了滑动窗口注意力,一般是滑动窗口和全局组合在一起,例如经过 3 个短窗口再过 1 个全局窗口。这就给 RoPE 和 NoPE 的结合提供了一种新的思路。 Llama 4 的 iRoPE(interleaved RoPE)就这样诞生的:
- 局部层:使用 RoPE,并把注意力限制在一个局部窗口或 chunk 内;
- 全局层:不使用显式位置编码,即 NoPE,允许 query 访问整个历史上下文;
- 层间交错:局部 RoPE 层负责稳定的局部顺序建模,全局 NoPE 层负责跨远距离检索。
可以用一个简化的层序列表示:
\[[\underbrace{\mathrm{RoPE\text{-}Local}, \mathrm{RoPE\text{-}Local}, \mathrm{RoPE\text{-}Local}}_{\text{局部位置建模}}, \underbrace{\mathrm{NoPE\text{-}Global}}_{\text{全局检索}}, \ldots].\]如果局部窗口大小为 $W$ ,局部层在 causal mask 作用下可见性可以粗略写成
\[M_{i,j}^{\mathrm{local}} =\mathbf 1[j\le i] \mathbf 1\left[\left\lfloor\frac{i}{W}\right\rfloor =\left\lfloor\frac{j}{W}\right\rfloor\right],\]而全局 NoPE 层只保留因果约束:
\[M_{i,j}^{\mathrm{global}} =\mathbf 1[j\le i].\]正好和之前的研究串联起来,当使用 RoPE 时,只需要关注局部的信息,使用 RoPE 对近距离形成感知,而全局使用 NoPE ,则依赖模型自行隐式地学习长距离关系:
- RoPE 层只处理有界距离,位置旋转始终处在熟悉的范围内,能够提供稳定的局部顺序、邻近关系和 recency bias;
- NoPE 层不需要把任意远的 token 映射到某个旋转角度,而是直接根据内容相似性完成检索;
- 交错结构让信息可以在局部聚合和全局读取之间反复传递,局部层为全局层提供已经整理过的局部结构,全局层再把远处的信息送回残差流。
可以参考 Llama 4 的介绍:
- The Llama 4 Herd: The Beginning of a New Era of natively multimodal AI innovation
- Llama 4 model implementation
这也就可以看成是一种位置建模的分工。接下来的部分会根据三篇论文讨论怎么让 iRoPE 在模型中更好地发挥作用。
5.2 去除 NoPE 层的 QK-Norm
论文 Rope to Nope and Back Again: A New Hybrid Attention Strategy 给出了第一个尝试:不在全局 NoPE 层使用 QK-Norm。
标准 attention 的 logit :
\[s_{i,j}=\frac{\boldsymbol q_i^{\mathsf T}\boldsymbol k_j}{\sqrt d}.\]加入 QK-Norm,query 和 key 会先被归一化:
\[\hat{\boldsymbol q}_i=\frac{\boldsymbol q_i}{\|\boldsymbol q_i\|}, \qquad \hat{\boldsymbol k}_j=\frac{\boldsymbol k_j}{\|\boldsymbol k_j\|},\]然后使用近似余弦相似度的分数
\[a_{i,j}^{\mathrm{QK\text{-}Norm}} =\frac{\hat{\boldsymbol q}_i^{\mathsf T}\hat{\boldsymbol k}_j}{\tau}.\]其中 $\tau$ 是可学习或预设的温度参数。这样做通常有助于缓解训练初期的数值不稳定,但也会抹掉 query 和 key 的范数信息。QK-Norm 能有效防止 Softmax 饱和,使注意力分数的分布更加平滑。这直接减少了训练过程中的损失尖峰,让更大、更深的模型能够稳定地训练下去。
在这篇论文中,研究者对 QK-Norm 的使用提出了一些担忧。论文认为,QK-Norm 会损害长上下文建模。QK-Norm 削弱了 Query 和 Key 点积中的幅度信息,导致注意力 logits 的幅度更接近、分布更平坦,结果注意力更分散,信噪比更低,不利于精确检索。所以论文在全局 NoPE 层关闭 QK-Norm,而在局部 RoPE 层中仍然保留了 QK-Norm.
为了验证这个观点,论文比较了 RoPE、QK-Norm 和 NoPE 三种模型在长上下文 NIAH 实验的效果。简单来说,这个实验在长段文档里插入一条 Needle 信息,然后要求模型根据问题去检索它。把输入的文档分成四个部分:
- Begin: 序列最开头的前 10 个 token, 通常对应 attention sink。模型会习惯性地把大量注意力放在开头这些 token 上,即使它们内容不一定相关。
- Needle: 被插入到长文档中的 Needle 句子,这是真正需要被检索的目标信息。理想情况下,模型应该给这部分较高注意力,才能答对问题。
- End: 当前 query token 和 completion token 所在的部分,靠近序列末尾,代表近邻偏好,考察模型是否倾向于关注最近出现的 token。
- Context: 除上述三部分外的其余上下文,多数是噪声或与问题无关的信息。模型应该尽量少被它干扰。
实验里使用 End 段的 query token 去算注意力,观察这些 query 对四个区域里的 key token 分别分配了多少注意力,然后把注意力分数按区域汇总、跨所有 head 和 layer 平均,得到每个区域的 attention mass。
论文发现 QK-Norm 变体在 Needle 上注意力最低,在 Context 上注意力很高,同时 Begin 注意力也低,说明它 attention sink 弱、更容易被无关上下文干扰,所以长上下文检索表现差。
5.3 缩小局部窗口长度
直觉上,局部窗口越大,模型看到的信息越多,长上下文能力应该越好。但 Rethinking the Role of Efficient Attention in Hybrid Architectures 对此提出质疑:在混合架构中,过大的局部窗口可能让真正负责全局检索的层变得“懒惰”。
对于使用滑动窗口的模型有两类层:局部层和全局层。如果局部窗口很大,局部层已经覆盖了大量常用的上下文依赖,模型只依靠窗口内的信息就能完成 next-token prediction。这样一来,优化器没有足够压力去训练全局层形成检索头。这在有限训练预算或低数据阶段尤其明显,这就是 Large-Window Laziness。换句话说,过长的局部窗口已经近似于全局窗口,模型没有动力再全局窗口去学习全局的检索能力。反而当局部窗口较小,许多有用依赖天然落在窗口之外,为了降低训练损失,模型必须尽早学会利用全局层去找远处的信息,全局层会得到更密集的长距离检索训练信号。
论文用两个角度验证了这个现象。
第一,梯度影响分析。论文使用 Llama 3.1-8B 测量预训练语料中长文档上 next-token prediction 信号随距离 $d$ 的衰减情况,对输入 $x_{1:T}$ 定义为:
\[G(d)=\mathbb{E}_x\left [\left \|\frac{\partial s(x)}{\partial e_{T-d}}\right\|_2\right],\]$e_{T-d}$ 是距离 $d$ 的 token 的 embedding, $s(x)$ 是模型在 $x$ 上的 next-token prediction 的 logit。这个可以用来量化每个历史 token 对模型预测有多敏感,也就是如果稍微改变位置 $T−d$ 处的输入 embedding,模型的输出 logit 会发生多大变化。 数值越大,说明模型当前的预测高度依赖该位置的 token,该 token 携带了完成当前预测所必需的关键信息。而数值越小,说明该位置的 token 对当前预测几乎无关紧要,模型可以忽略它。如果 $G(d)$ 在某个距离范围内仍然显著,意味着全注意力层在该距离上能接收到足够强的梯度来学习去那个位置找信息。
实验发现:位置 2048 token 之外的梯度影响已经接近平坦基线,但位置 512 到 2048 的区间仍然包含明显信号。当局部窗口选择一个较小的值,如 128 或者 512,模型仍然有很强的动力在全局层去学习 512-2048 之前的依赖关系,而如果局部窗口直接取到 2048,全局层就很容易被局部层替代。
第二,检索头追踪。通过追踪两个指标:
- 在 NIAH 任务检索 needle token 时的归一化注意力熵,越小代表检索越锐利;
- 第 $t$ 步的检索头的 Q/K 投影矩阵相对于最终 checkpoint 的参数距离,越小表示越收敛。
实验发现:局部窗口大小设置 128,512,2048 和不使用滑动窗口的机组实验中,局部窗口大小 2048 是明显的异常值,其检索头的注意力熵持续偏高,Q/K 权重收敛更慢,表明检索头处于欠训练状态。
总之,这给 iRoPE 的启发是:局部窗口不是越大越好,而要给全局 NoPE 层留下必须完成的工作。
值得注意的是,Large-Window Laziness 更像一个优化动力学现象,而不是说大窗口在充分训练后必然更差。论文的 scaling 实验显示,训练预算足够时,不同高效注意力架构的长上下文差距会逐渐缩小;大窗口最明显的问题出现在低数据、早期训练和有限预算场景。
5.4 改变滑动窗口结构和对注意力 logit 继续缩放
一般使用滑动窗口会设置长短窗口比例为 1:1 或 1:3,当使用 1:3 比例,一般会设置先过 3 个短窗口再过 1 个长窗口,即”SSSL”。但 SWAN-GPT: An Efficient and Scalable Approach for Long-Context Language Modeling 改成了 “LSSS”。
论文对此提供的解释是:如果先过局部层并且使用 RoPE,隐藏状态已经被注入了强烈的、与训练长度绑定的 RoPE 位置信号。当这些状态随后进入全局 NoPE 层时,NoPE 层会被迫处理这些位置信号,导致 NoPE 层发展出脆弱的隐式位置编码,外推时崩溃。而先过全局 NoPE 此时输入是纯粹的 token embedding,不含任何位置信息。NoPE 层可以在一个干净的环境中学习纯内容相关的语义整合,之后的局部层 使用 RoPE 再在此基础上叠加局部位置关系。
此外,SWAN-GPT 在推理时对注意力 logits 进行动态缩放,重点针对全局 NoPE 层。作者通过实验估计不同序列位置所需的缩放因子,发现以下对数函数能够很好地拟合这些估计值:
\[g(n)=\log_a(a + n)\]其中 $n$ 表示序列位置, $a$ 是一个通过离线拟合得到的单一标量超参数(论文中 $a^* \approx 362$ ),控制曲线的增长速度。拟合过程如下:
- 从模型的训练分布中抽取 200 篇文档,每篇至少包含 32K token,以在延长上下文时尽量保持语义分布一致;用于这一分析的模型训练长度为 1K token。
- 将每个 32K-token 上下文划分为 128-token 窗口,对每个窗口估计一个缩放因子,以最小化全部 200 篇文档上该窗口的困惑度。
- 用 $\log_a(a+n)$ 拟合不同位置的估计值,并与 YaRN 的缩放函数比较。实验发现,对数函数更符合这些 NoPE 层的实验结果。
论文强调,该函数随位置增长,且在 $n\ge0$ 时始终不低于 1。
从注意力机制本身看,全局 NoPE 层可见的历史 token 数量会随序列位置增加,参与 softmax 归一化的候选也随之增多。在 logits 的区分度没有相应增强时,关键 token 的注意力权重可能被更多候选稀释。
有意思的是,这个拟合的函数可能和信息论某种程度上对应。全局注意力中,参与 softmax 竞争的 token 数量随序列长度 $N$ 线性增加。而根据 Shannon 信息论,区分 $N$ 个均匀符号所需的信息量下界恰好是 $\log N$ 。
6. 通用能力与训练效率的初步实验
我们选择了 Karpathy 的 Nanochat 项目来进行验证以上关于位置编码的探讨。
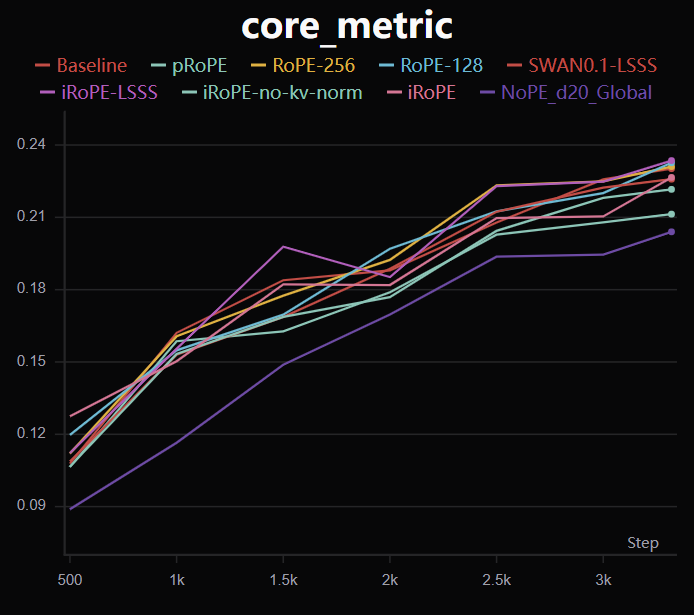
实验使用了 20 层 Transformer 架构,大概 560M 的参数量,衡量训练吞吐量的指标使用 token_per_second,即每秒钟处理的训练 token 数。 衡量模型能力的指标主要是 val_bpb 和 CORE:
-
val_bpb是平均每个 token 的 bits-per-byte 指标,越小越好,相比于原始的 cross-entropy loss,bpb 使得不同词表大小或不同配置下的模型性能更具可比性; -
CORE源自 DCLM ,是大模型在一系列下游任务中的指标平均数,越大越好。
在两张英伟达显卡训练得到结果如下:
| 模型 | token/s | val_bpb | CORE |
|---|---|---|---|
| RoPE | 1.3473e+5 | 0.7551 | 0.2301 |
| NoPE+不使用滑动窗口 | 1.3062e+5 (-3.05%) | 0.7673 (+1.62%) | 0.2039 (-11.39%) |
| p-RoPE | 1.3663e+5 (+1.41%) | 0.7548 (-0.04%) | 0.2113 (-8.17%) |
| iRoPE | 1.3776e+5 (+2.25%) | 0.7557 (+0.08%) | 0.2256 (-1.96%) |
| iRoPE + 去除 QK-Norm | 1.387e+5 (+2.95%) | 0.7597 (+0.61%) | 0.2216 (-3.69%) |
| iRoPE + 缩小局部窗口 256 | 1.4161e+5 (+5.11%) | 0.7553 (+0.03%) | 0.231 (+0.39%) |
| iRoPE + 缩小局部窗口 128 | 1.4291e+5 (+6.07%) | 0.7553 (+0.03%) | 0.2326 (+1.09%) |
| iRoPE + 滑动窗口 LSSS | 1.3771e+5 (+2.21%) | 0.7573 (+0.29%) | 0.2335 (+1.48%) |
| iRoPE + 滑动窗口 LSSS + 缩放 | 1.3748e+5 (+2.04%) | 0.7659 (+1.43%) | 0.2258 (-1.87%) |
其中把第一个实验 RoPE 设置成为 baseline,同时使用了滑动窗口,局部窗口大小为 512,全局窗口大小为 2048,使用 1:3 的比例”SSSL”,即先经过 3 个局部窗口,再经过 1 个全局窗口。而考虑到 NoPE 更多地是对长上下文有帮助,所以没有使用滑动窗口(我们也进行了使用 NoPE 和滑动窗口的实验,表现确实不如 NoPE 配上不使用滑动窗口)。
最后一个实验中根据 SWAN-GPT 拟合函数的方法,我们也采集了一批预训练文本的数据,但是并没有观察到论文中使用的 $\log$ 缩放因子,所以我们尝试使用初等函数拟合,结果是一个常函数,最终等价于温度为 0.1, 即 $\frac{s}{0.1}$ ,以此作为一个简单的复现尝试。
分析结果可以看到,除了 NoPE 和 p-RoPE 明显让模型能力下降,其他的模型和 RoPE 相比都没有很大差别。需要注意的是,这只是在小模型上表现出来的能力,指标也都具有偶然性;另外,之前的论文介绍更多的是聚焦模型上下文长度泛化的能力,而这里的 CORE 是对通用能力的考验,所以此次实验结果仅作为一个简单的参考。
顺带一提,在运行这个实验的过程中,我们使用了 SwanLab 来记录实验数据,这是一个对标 WandB 的国产工具,具有指标可视化记录、硬件监控、多人协作等功能。
7. 总结:让位置建模各司其职
回到文章开头的问题:长上下文模型需要怎样的位置编码?沿着 RoPE、NoPE、p-RoPE 和 iRoPE 这条线看下来,我更倾向于认为,局部顺序建模和远距离内容检索需要的位置信息并不相同,模型可以为它们安排不同的计算通道。
RoPE 的优势在于把相对位置先验直接写进注意力计算,让模型容易学会相邻关系、局部顺序和精细的位置模式。但旋转也让内容匹配受到距离的调制:当上下文不断拉长,原本变化缓慢的通道也会积累相位偏移,语义相关性可能被位置干扰。增大 base 或调整频率可以缓解部分问题,却仍然需要在位置分辨率和内容匹配的稳定性之间权衡。
NoPE 则说明,显式位置编码并不是 decoder-only Transformer 获得位置信息的唯一途径。因果掩码、锚点 token 和网络计算可以共同支持隐式的位置表示。不过,能够构造出这样一组参数,与模型在有限数据和训练预算下稳定学到它,是两回事。这也解释了为什么 NoPE 在部分算法任务中展现出长度泛化优势,却未必能在真实语言建模中直接替代 RoPE。
p-RoPE 和 iRoPE 提供了两种分工方式:前者在一个 head 内保留部分旋转通道,同时留下不旋转的内容匹配通道;后者在不同层之间安排局部 RoPE 和全局 NoPE,让局部结构建模与远距离检索相互配合。iRoPE 的分工能否发挥作用,还取决于训练和注意力结构。局部窗口大小会影响全局层是否有足够动力学习检索,QK-Norm 会改变打分中可利用的幅度信息,层的排列顺序和 logits 缩放也会影响信息传递与注意力分布。因此,混合设计需要结合模型规模、数据和训练预算来判断。
我们的 Nanochat 实验给出了一些初步信号:纯 NoPE 配合全局注意力时,通用能力指标明显下降;iRoPE 则整体接近 RoPE 基线。其中,把局部窗口缩小到 128 后,训练吞吐量提升约 6.07%,CORE 提升约 1.09%,val_bpb 基本持平;LSSS 排列取得了本组实验最高的 CORE,但额外缩放没有带来收益。
参考文献
一、位置编码与 RoPE 基础(第 1 章)
[1] 苏剑林. 让研究人员绞尽脑汁的 Transformer 位置编码. 科学空间, 2021-02. https://spaces.ac.cn/archives/8130
[2] 苏剑林. Transformer 升级之路:2、博采众长的旋转式位置编码. 科学空间, 2021. https://spaces.ac.cn/archives/8265
[3] Jianlin Su et al. RoFormer: Enhanced Transformer with Rotary Position Embedding. Neurocomputing, 568: 127063, 2024. arXiv:2104.09864
二、RoPE 的长上下文失效(第 2 章)
[4] Yufeng Du et al. RoPE Distinguishes Neither Positions Nor Tokens in Long Contexts, Provably. arXiv:2605.15514, 2026-05(NeurIPS 2026 在审). arXiv:2605.15514
三、NoPE 与隐式位置编码(第 3 章)
[5] Amirhossein Kazemnejad et al. The Impact of Positional Encoding on Length Generalization in Transformers. NeurIPS 2023. arXiv:2305.19466
四、混合设计:p-RoPE 与 iRoPE(第 4、5 章)
[6] Federico Barbero et al. Round and Round We Go! What makes Rotary Positional Encodings useful?. arXiv:2410.06205, 2024-10(v3 修订于 2025-05). arXiv:2410.06205
[7] Bowen Yang et al. Rope to Nope and Back Again: A New Hybrid Attention Strategy. arXiv:2501.18795, 2025-01(v2 修订于 2025-10). arXiv:2501.18795
[8] Ziqing Qiao et al. Rethinking the Role of Efficient Attention in Hybrid Architectures. arXiv:2606.15378, 2026-06. arXiv:2606.15378
[9] Krishna C. Puvvada et al. SWAN-GPT: An Efficient and Scalable Approach for Long-Context Language Modeling. arXiv:2504.08719, 2025-04. arXiv:2504.08719
[10] Meta AI. The Llama 4 Herd: The Beginning of a New Era of Natively Multimodal AI Innovation. Meta AI Blog, 2025-04. ai.meta.com/blog/llama-4-multimodal-intelligence
[11] Meta. llama-models:Llama 4 model implementation. GitHub, 2025. models/llama4/model.py
[12] Greg Kamradt. Needle In A Haystack(NIAH). GitHub, 2023-11. https://github.com/gkamradt/needle-in-a-haystack
五、评测与工具(第 6 章)
[13] Jeffrey Li et al. DataComp-LM: In Search of the Next Generation of Training Sets for Language Models. NeurIPS 2024 Datasets and Benchmarks Track. arXiv:2406.11794
[14] Andrej Karpathy. nanochat. GitHub, 2025-10. github.com/karpathy/nanochat
Enjoy Reading This Article?
Here are some more articles you might like to read next: